이번 글은 NKS(NCP Kubernetes Service) 기본 대시보드의 한계를 넘어서, Spring Boot Actuator와 Prometheus/Grafana 연동을 통해 JVM 내부 지표까지 관찰 가능하도록 구축한 경험을 공유합니다. 특히 신규 서비스 추가 시 ServiceMonitor가 작동하지 않았던 포트 누락 트러블슈팅 원인과 해결 과정을 안내합니다.
🔽이전글 돌아보기
🟢Telegram Bot API로 간단 시스템 모니터링
🟢웹훅(WebHook)을 이용한 쿠버네티스 간단 HPA 시스템 모니터링
Intro
지난 블로그에서는 “웹훅을 이용한 쿠버네티스 간단 HPA 모니터링”에 대해 알아 보았습니다.
이번 글에서는 NKS(NCP Kubernetes Service) 기본 모니터링의 한계를 극복하기 위해, Prometheus/Grafana를 직접 구축하고 Spring Boot Actuator와 연동하는 과정을 공유하려 합니다. 특히 구축 과정에서 실제로 부딪혔던 병목 지점과 ServiceMonitor가 정상적으로 동작하지 않았을 때 해결했던 트러블슈팅 경험을 마지막에 소개해드리려고 합니다.
모니터링 구축 배경 및 목적 (Goal)
GrowthPlatform은 7개 이상의 Spring Boot 서비스로 구성되어 있습니다. NKS 콘솔에서 기본 제공하는 대시보드는 노드 및 파드 수준의 CPU/메모리 지표만 보여주기 때문에, JVM Heap/Non-Heap 메모리나 애플리케이션 내부 요청 지표를 확인하기에는 한계가 있고, 실제 디버깅하는데도 노드별로 접속하여 직접 App단에 log를 확인해야하는 번거로움이 있었습니다.
이번 모니터링 구축의 주요 목적은 다음과 같습니다.
- 단일 화면 관찰: JVM 메모리 상태와 HTTP 요청 지표를 한 대시보드에서 시각화
- 이상 징후 알림: 장애 발생 전 모니터링 지표 기반의 이상 징후 감지 및 알림 수신
애플리케이션 설정 및 보안 고려 사항
여기에서 애플리케이션 설정을 고려했던 사항은 다음과 같습니다.
- 엔드포인트 무분별 노출 금지:
include: *설정 시 서버의 모든 내부 정보가 외부로 노출될 위험이 있습니다. 화이트리스트 방식으로 필요한 메트릭만 활성화(prometheus, health, info)해야 합니다.
2. Heapdump 유출 위험: Actuator가 제공하는 /actuator/heapdump 엔드포인트는 현재 서비스가 점유 중인 Heap 메모리 덤프를 제공합니다. 운영 중 메모리에 남아있는 중요 데이터가 유출될 수 있으므로 반드시 접근을 차단해야 합니다.
3. 포트 분리 및 접근 제어: 사용자 트래픽 포트(7070)와 관리/모니터링용 포트(7071)를 분리하고, 보안 그룹(Security Group) 설정을 통해 모니터링 서버만 Private IP로 접근할 수 있도록 제한합니다.
Maven 의존성 및 Spring Boot 설정
<dependency>
    <!-- 애플리케이션 상태 및 메트릭 노출 -->
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>


<dependency>
    <!-- Actuator 메트릭을 Prometheus 읽기 포맷으로 변환 -->
    <groupId>io.micrometer</groupId>
    <artifactId>micrometer-registry-prometheus</artifactId>
</dependency>
management:
endpoints:
web:
exposure:
include: "prometheus, health, info" # 필요한 엔드포인트만 화이트리스트로 노출
server:
port: 7071 # 사용자 포트(7070)와 분리된 모니터링 전용 포트
base-path: /aaaaa/actuator/prometheus# 서비스별 공통/개별 진입 경로 (예: /aaaaa)Note: base-path를 설정한 경우, Prometheus가 수집할 엔드포인트 최종 경로는 /aaaaa/actuator/prometheus가 됩니다. 각 서비스의 진입 경로 규칙에 맞게 일치시켜 주어야 합니다.
K8s Service & ServiceMonitor 트러블 슈팅
Kubernetes 환경에서 Prometheus가 Pod의 메트릭을 올바르게 수집하려면 Service와 ServiceMonitor 간의 매핑 규칙을 정확히 준수해야 합니다.
등록한 서비스는 정상적으로 대시보드에 메트릭이 수집되었으나, 새롭게 추가한 서비스들은 ServiceMonitor를 등록했음에도 불구하고 Grafana 대시보드 및 Prometheus Target 목록에 아무런 지표가 나타나지 않았습니다.
수집이 잘 되는 기존 설정과 수집되지 않는 서비스의 설정을 비교해 본 결과, 원인은 Service 매니페스트 설정 누락이었습니다.
- ServiceMonitor는
port: metrics지침에 따라metrics라는 이름을 가진 포트을 확 - 하지만 신규 서비스들의 Service YAML에는 사용자 트래픽 포트만 정의되어 있고,
7071번 모니터링 포트가 아예 없음 - 이로 인해 Prometheus는 대상을 찾지 못해 Targets 목록에서 수집 실패 상태가 발생
수집되지 않던 서비스들의 Service 매니페스트에 아래와 같이 metrics 포트를 새로 정의하여 반영했습니다
ports:
    - name: http
      port: 7070
      targetPort: 7070
    - name: metrics # 해당 포트 설정 추가
      port: 7071
      targetPort: 7071
설정을 마친후 Grafana 대시보드를 통해 주요 JVM메트릭을 실시간으로 모니터링할 수 있게 되었습니다.
- 초당 GC 발생 횟수 (Young+Old 합산) (PromptQL)
sum(rate(jvm_gc_pause_seconds_count[5m])) by (namespace, pod)- Heap / Non-Heap 사용량 합산 표시 (PromptQL)
sum(jvm_memory_used_bytes{area="heap"}) by (pod)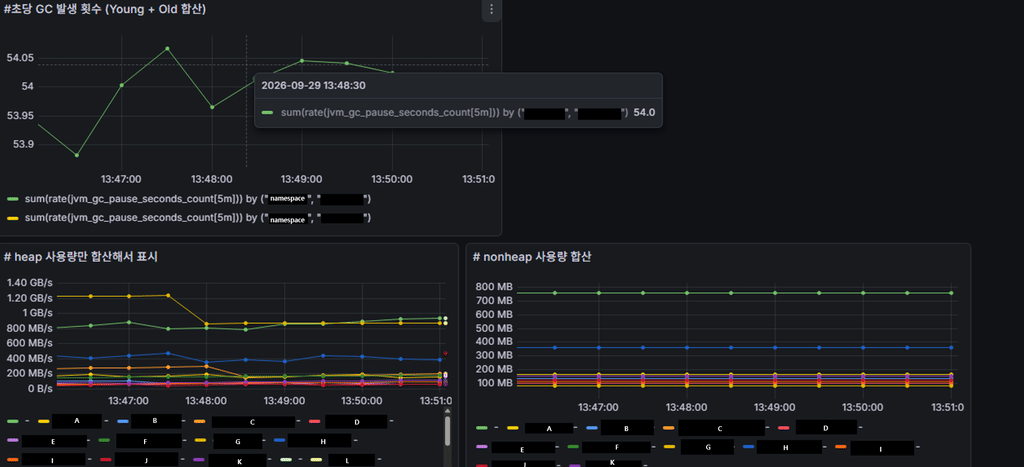
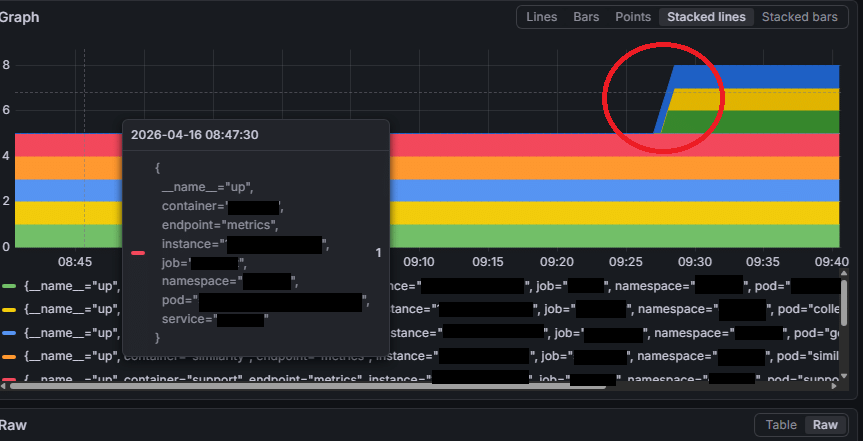
혹시 ServiceMonitor를 설정했음에도 Grafana 대시보드에 메트릭이 정상 노출되지 않는다면, 다음 3가지를 체크해 보시길 권장합니다.
- Service 매니페스트에 모니터링 포트(
metrics)가 명시되어 있는가? - Service의 라벨과 ServiceMonitor의 selector 라벨이 완전 일치하는가?
- Actuator의
base-path와 ServiceMonitor의path경로가 일치하는가?
Spring Boot Actuator와 Prometheus/Grafana 연동을 통해 쿠버네티스 환경 내 애플리케이션 내부 상태까지 세밀하게 모니터링할 수 있는 Observability 기반을 다졌습니다.
다음 글에서는 모니터링 지표를 바탕으로 이상 징후 발생 시 Alertmanager와 Google Chat을 연동하여 실시간 장애 알림 환경을 구축하는 과정에 대해 공유하겠습니다.
감사합니다.
#References
- https://docs.spring.io/spring-boot/api/rest/actuator/heapdump.html
- https://techblog.woowahan.com/9232/
- https://toss.tech/article/how-to-work-health-check-in-spring-boot-actuator
최신 마케팅/고객 데이터 활용 사례를 받아보실 수 있습니다.