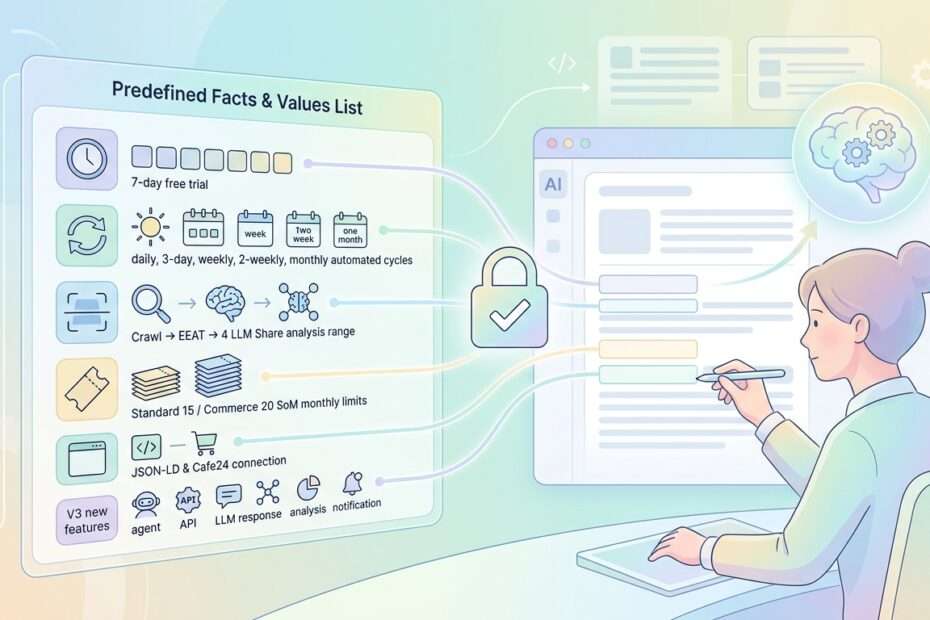
사실관계를 미리 정해 두면 원고가 그 값만 씁니다
AI 원고의 수치 오류는 작성 후 검수보다 작성 전 사실 목록 정리로 막는 것이 효과적입니다. 확정된 값만 쓰고 미정 값은 배제하는 방식의 실무 적용법을 다룹니다.
콘텐츠 기획·생산·채널 배포 자동화 관련 콘텐츠
AI 원고의 수치 오류는 작성 후 검수보다 작성 전 사실 목록 정리로 막는 것이 효과적입니다. 확정된 값만 쓰고 미정 값은 배제하는 방식의 실무 적용법을 다룹니다.
새 주제를 짜내는 대신, 측정 데이터 속 인용되지 않은 질문 목록을 그대로 콘텐츠 백로그로 활용하는 방법을 설명합니다.
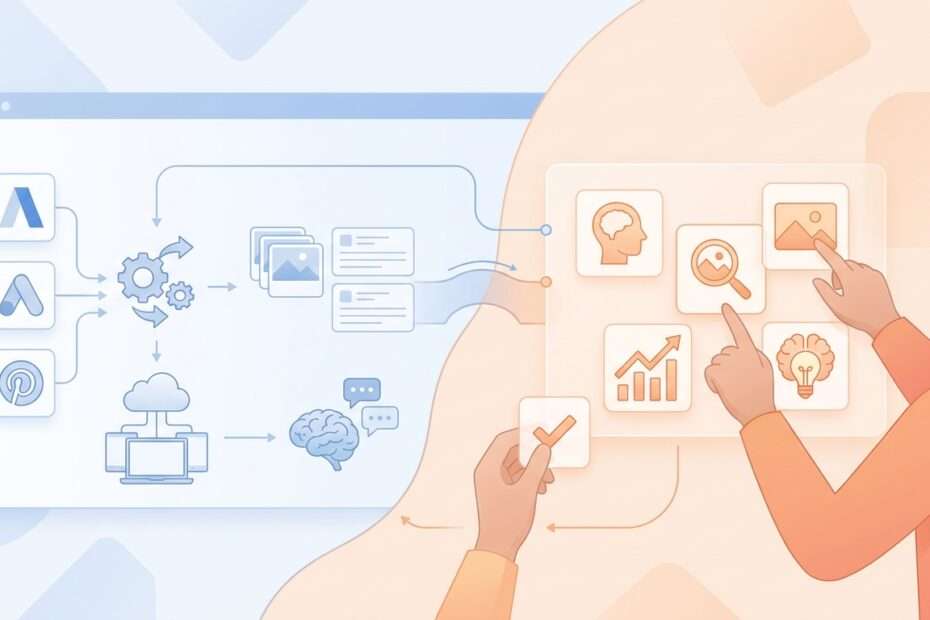
자동화에 맡길 반복 작업과 사람이 계속 봐야 할 판단 작업의 경계를 실무 예시로 구분해 설명합니다.
콘텐츠 회의가 매번 백지에서 시작되는 이유는 아이디어 고갈이 아니라 이미 있는 데이터를 미리 보지 않아서입니다. 인용 공백을 먼저 확인하면 회의 방식이 달라집니다.
여러 시스템의 데이터를 AI에 연결하려면 먼저 데이터엔지니어링을 통한 정리와 적재가 필요한 이유를 설명합니다.
의료·금융 같은 규제 업종은 콘텐츠 검수가 아니라 생성 단계에서부터 기준을 세워야 합니다. 콘텐츠 운영이 멈추는 이유와 멀티채널 대응 방법을 살펴봅니다.
자동화가 대신할 수 있는 반복 작업과, 예산 변경·캠페인 집행처럼 사람이 직접 승인해야 할 결정을 구분해 설명합니다.
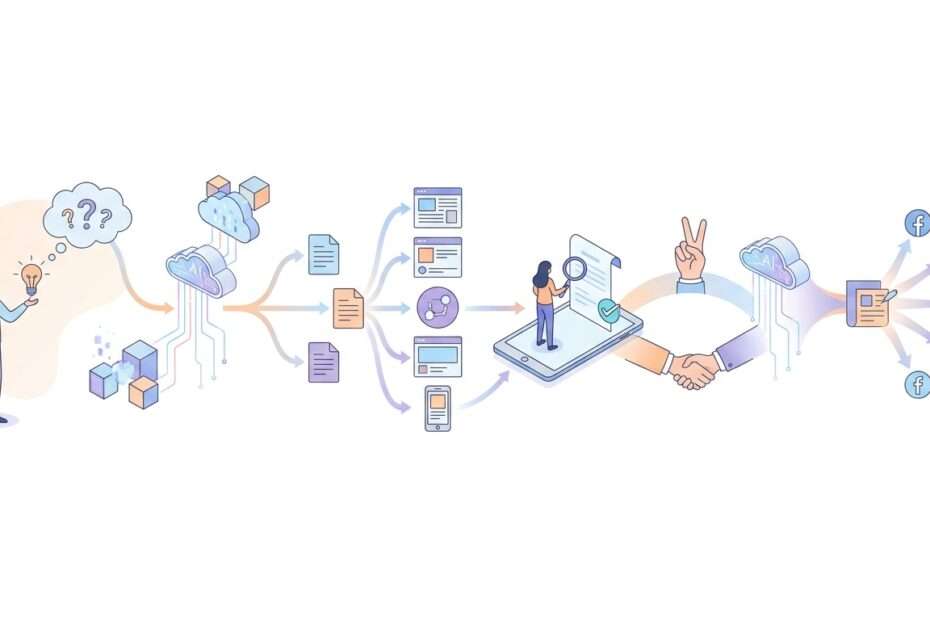
주제 발굴부터 발행까지 여섯 단계에서 사람과 시스템이 나눠 맡아야 할 역할을 구체적으로 정리했습니다.
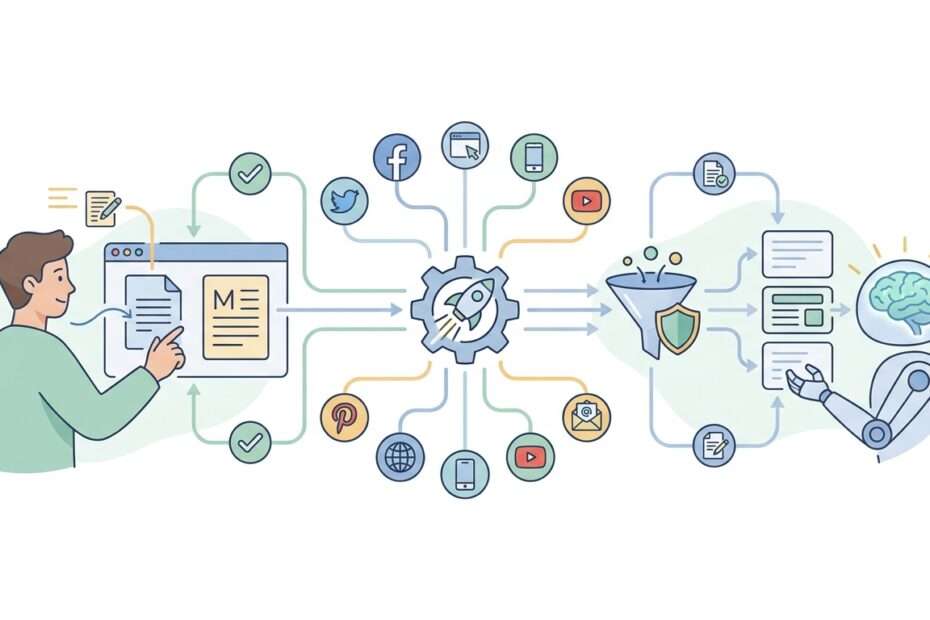
채널마다 콘텐츠를 다시 쓰고 수치·민감정보를 사람이 일일이 확인하는 병목을, 마스터 스토리 배포와 기능 기반 검수로 줄이는 방법을 소개합니다.
콘텐츠 운영이 멈추는 두 가지 병목과 하나의 기획으로 여러 채널을 커버하는 방법, 외주와 검수의 균형을 다룹니다.